一、问题现象
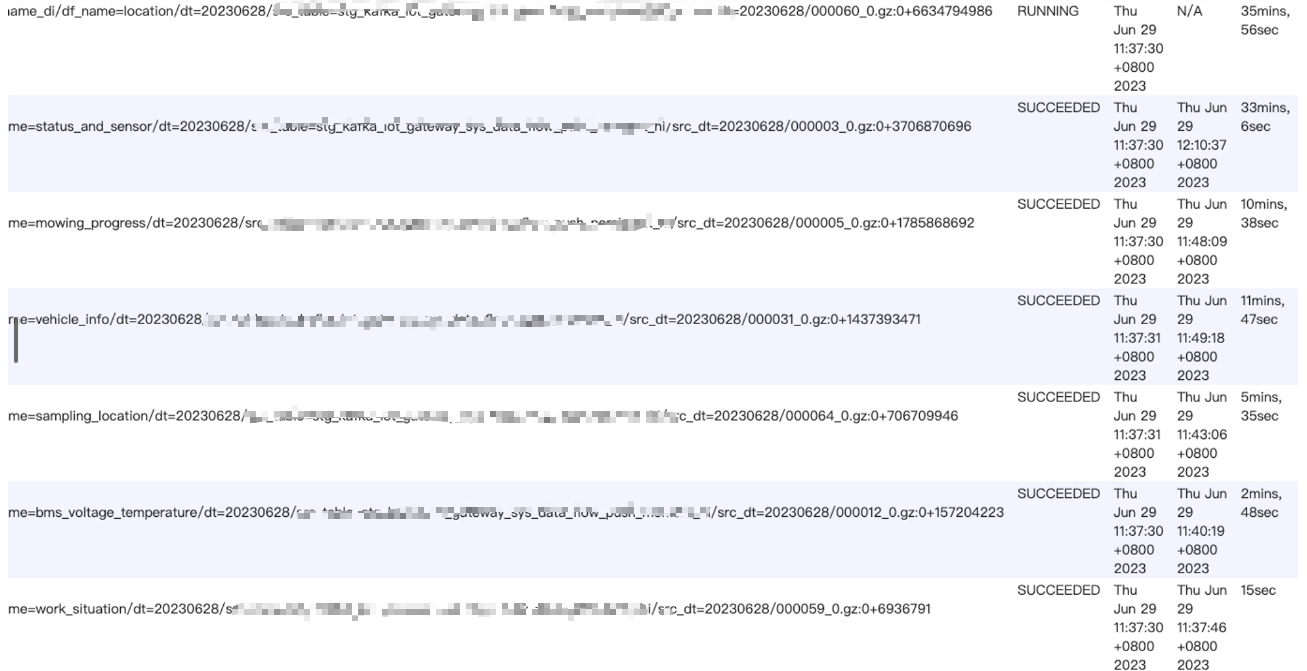
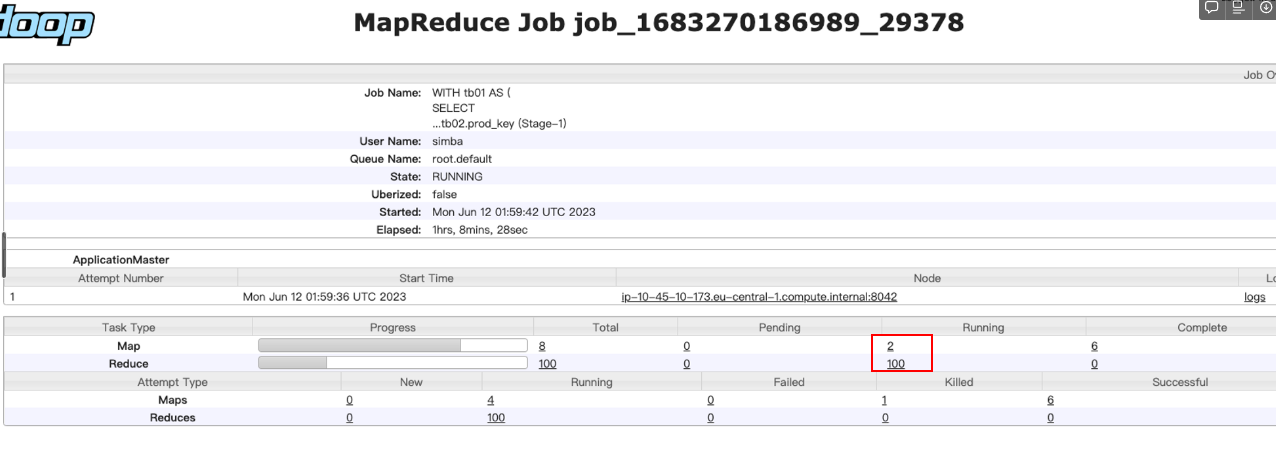
发现有多个任务出现数据倾斜问题,通过上面发现map很多就几分钟跑完了,有几个跑了很久才跑完的,时间差别有些大,并且这个时候有大量reduce在等待那一个map任务跑资源浪费
二、持续时间
从迁移到emr集群后
三、问题原因
查询上面任务查询的数据
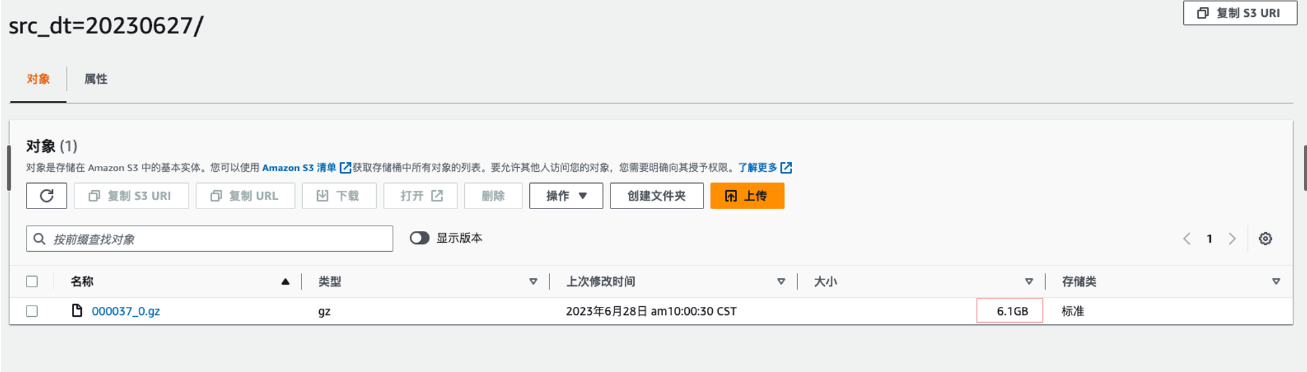
发现数据 都写成一个大文件了,而gz 文件 不支持分片,所以就会导致上游会出现大量一个map很慢的情况。
于是根emr的技术支持沟通,也没有给出一个彻底解决方案,于是我们把任务改成使用spark-sql 来实现。
改成sparks-sql 后变成多个小文件了
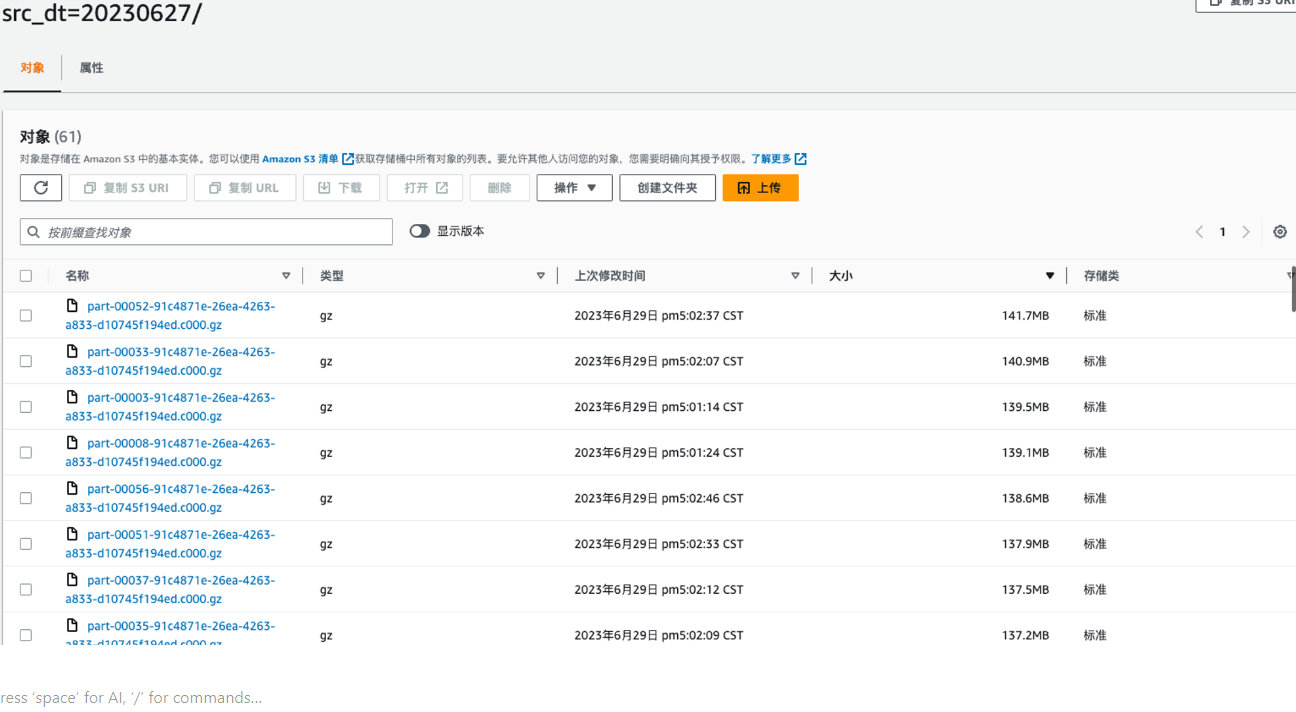
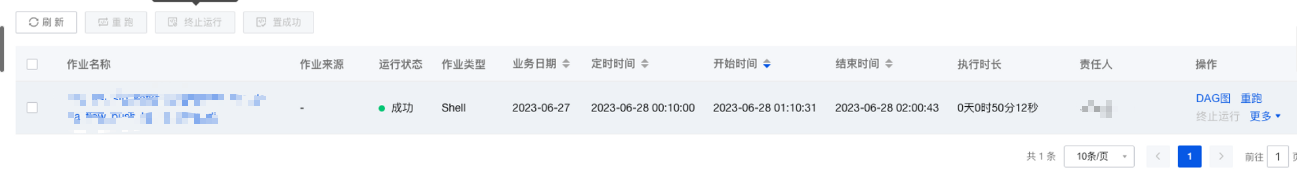
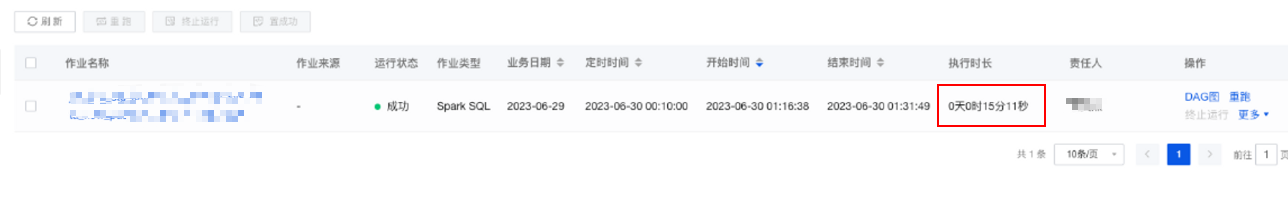
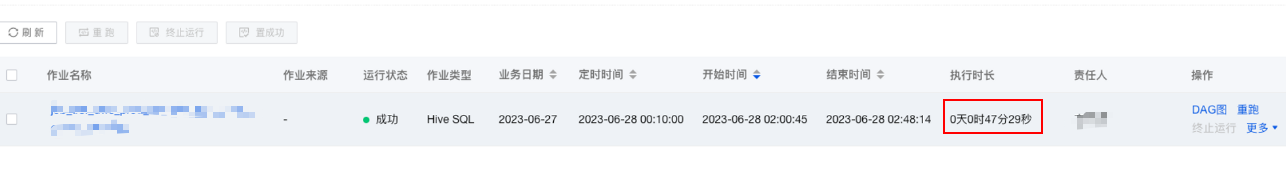
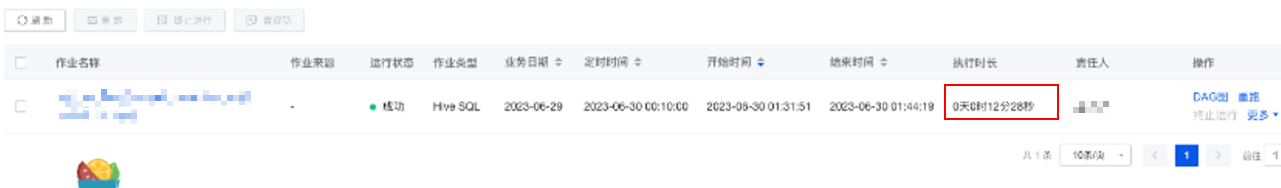
性能耗时对比(随机找了几个大下游任务对比的任务):
改造前: 任务运行50分钟
改造后: 15分钟
改造前: 47分钟
改造后: 12 分钟
改造前:2个小时
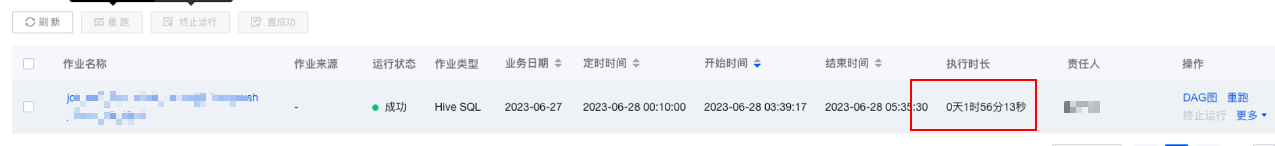
改造后:20 分钟
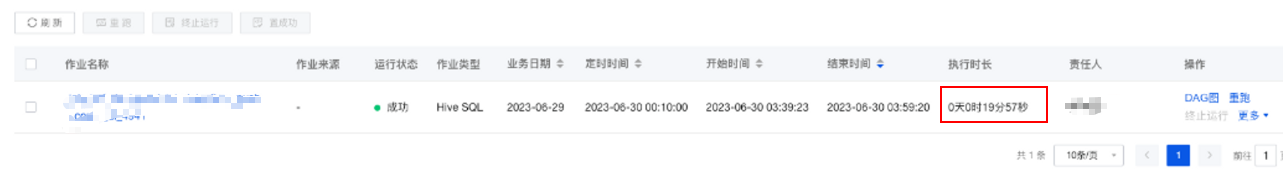
性能对比 升 节约 80% 所以任务跑的很快。
四、总结
- 在emr当中,hive 在写s3 会生成一个大文件,导致下游的任务会出现数据倾斜,任务运行时间长并且浪费资源,所以不要使用hive 使用spark-sql 替代.
- 遇到这种问题,要及时解决,以免造成不必要的资源浪费。
